使用 RAGFlow
1. 配置模型

LLM:是大语言模型,用于 RAGFlow 中的聊天功能;如果不使用 RAGFlow 中的聊天功能也可以不设置此模型;
Embedding:是向量模型,用于将输入文本转为数字向量,然后交给 Elasticsearch 进行检索。
VLM:视频语言模型,用于将要入库的图片、流程图、截图等视觉内容转为文本,以供 Embedding 模型向量化;
ASR:语音识别模型,用于将要入库的语音转换文字,以供 Embedding 模型向量化;
Rerank:重排序模型,用于对初步检索结果重新评估相关性;
TTS:语音合成模型,用于最终输出的文字转换语音播放给用户听;
文档入库流程:

知识检索流程:

2. 检索引擎
Elasticsearch :不仅支持全文检索,还支持向量检索(Vector Search),甚至可以同时进行全文检索和向量检索(Hybrid Search,混合检索)。
3. 切换模型
Embedding 模型并不是可以无成本替换的。知识库一旦完成向量完成,后续更换 Embedding 模型通常需要重新构建向量索引。因为不同 Embedding 模型生成的向量通常不属于同一个向量空间,不能直接混合比较。例如:分别使用模型 A 和模型 B 生成的向量如下:
模型 A:
[0.12, -0.35, 0.87, 0.21, ...]
  └── 假设为 1024 维向量

模型 B:
[-0.45, 0.18, 0.63, 0.92, ...]
  └── 假设为 1536 维向量
VLM 和 ASR 模型用于将视觉 和语音文件转为文本,因此理论上这两个模型可随时切换;但要在 RAGFlow 中找到这些结果文本,并重新与原始输入文档共同进行向量化,可能会比较麻烦。
其它模型切换都很容易。
4. 创建知识库

解析方法:内置 表示使用 RAGFlow 内置的文档解析与分块策略,配置简单,适合快速测试;Pipeline 是指使用预先定义的文档处理流水线, 适合大量 Word、PPT、PDF 混合,并且需要精细处理复杂表格、架构图和规范章节的场景。
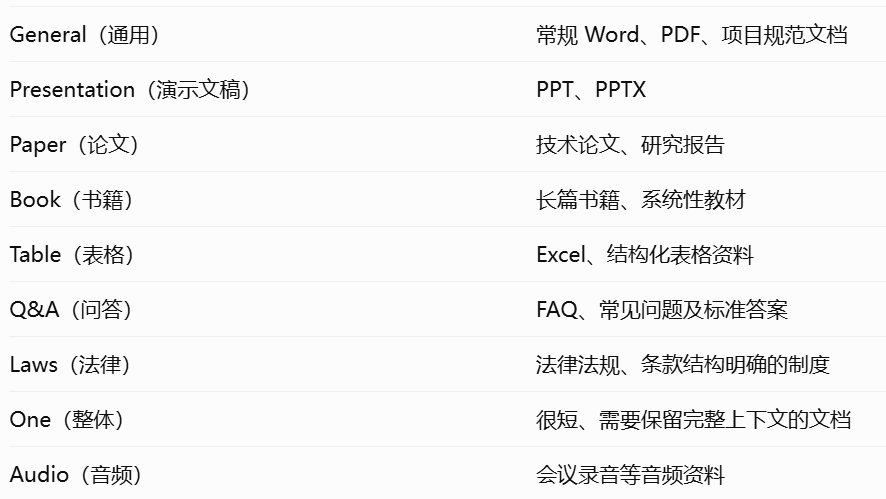
分块方法:
5. 向知识库中上传文档
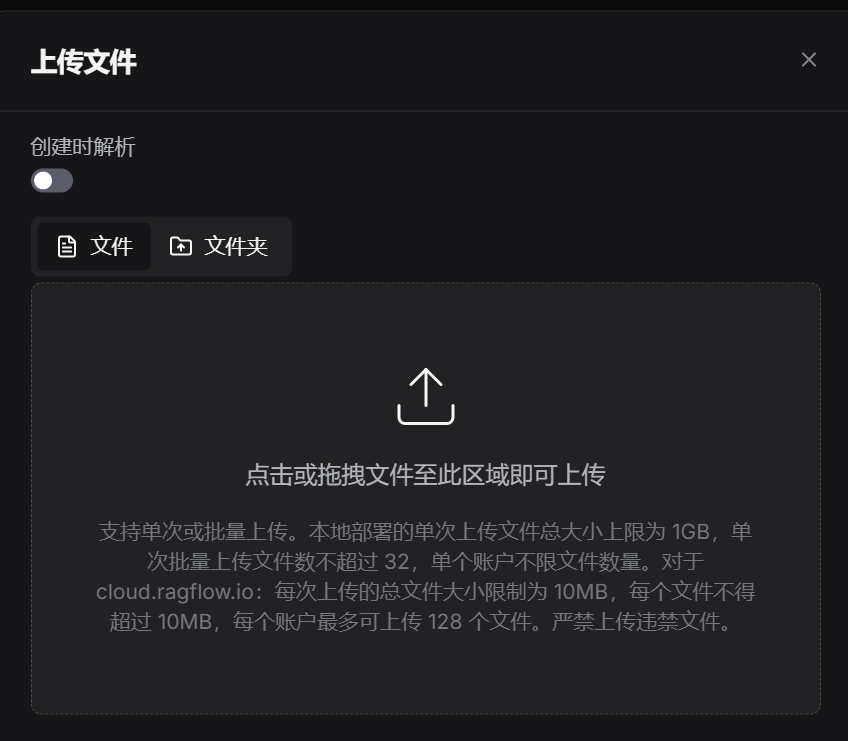
上传文档时有一个“创建时解析”的选项;如果文件没有经过解析,就无法参与 RAGFlow 的正常知识库检索,但文件仍然可以上传、保存和管理。
“创建时解析”这个选项存在的主要作用是:将文件上传与文档解析分离,让用户自行决定什么时候消耗计算资源、调用模型并建立检索索引。例如下:
- 批量上传文件,稍后统一解析,以避免短实践占用大量硬件资源或模型API配额;
- 批量上传后,先进行小范围向量化配置和测试,然后再决定是否全部解析。
6. 批量上传目录
RAGFlow 的产品定位是 RAG(检索增强生成)引擎,而不是企业文件管理系统,因此其对文件上传管理支持的并不友好;要通过 RAGFlow API 才能批量上传带有层级结构的本地目录;例如下:
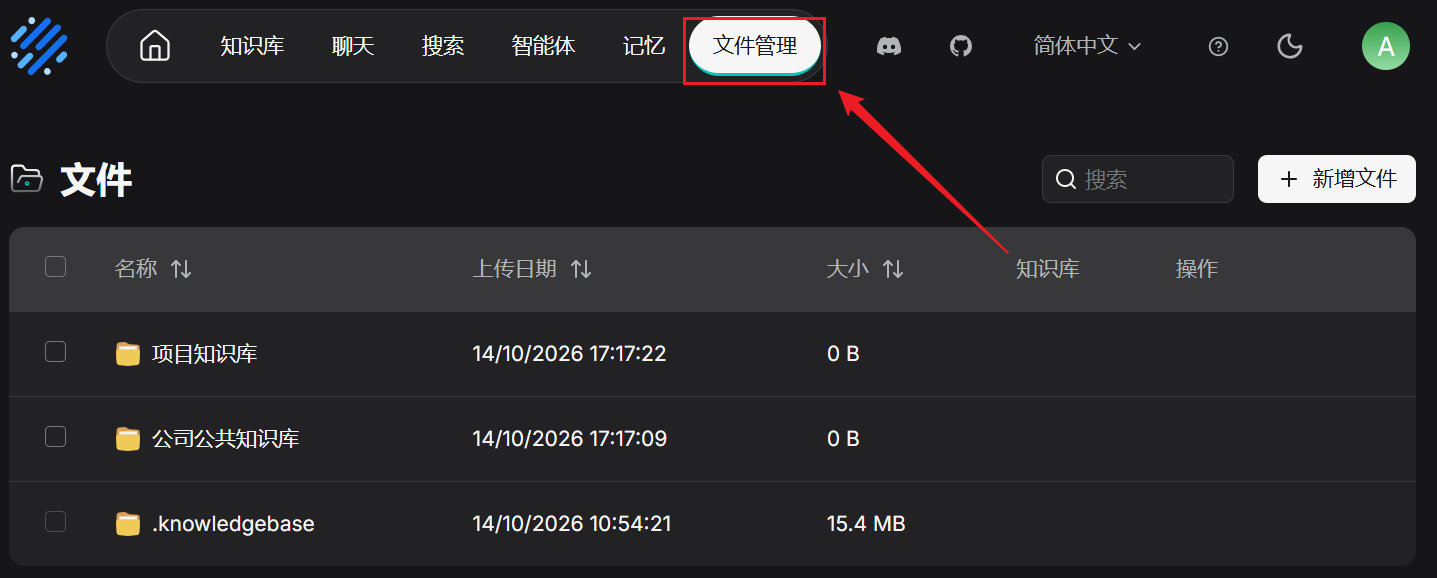
然后链接到指定知识库,例如下:
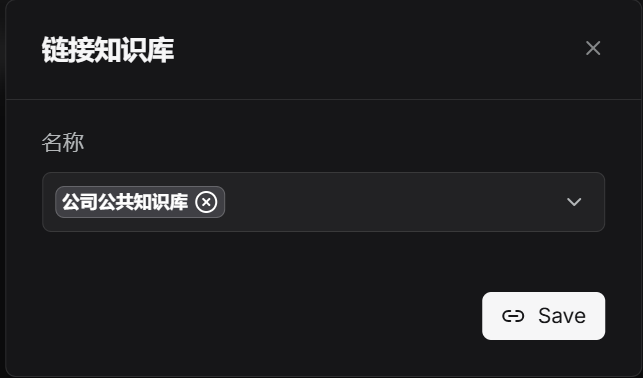
注意:主流的方式是不要把 RAGFlow 的文件管理功能作为公司知识文档的主要管理工具,应该采用“文件服务器统一管理原始文档 + 自动同步服务 + RAGFlow 知识库”的架构。如果使用自动同步的方式,就没有必要再使用 RAGFlow 的文件管理功能;且文件服务删除文件时,RAGFlow 知识库中的文件也要同步删除。
7. 获取 RAGFlow API Key
RAGFlow API Key 用于通过脚本操作 RAGFlow,例如:AI客户端MCP调用、RAGFlow批量文件上传等。
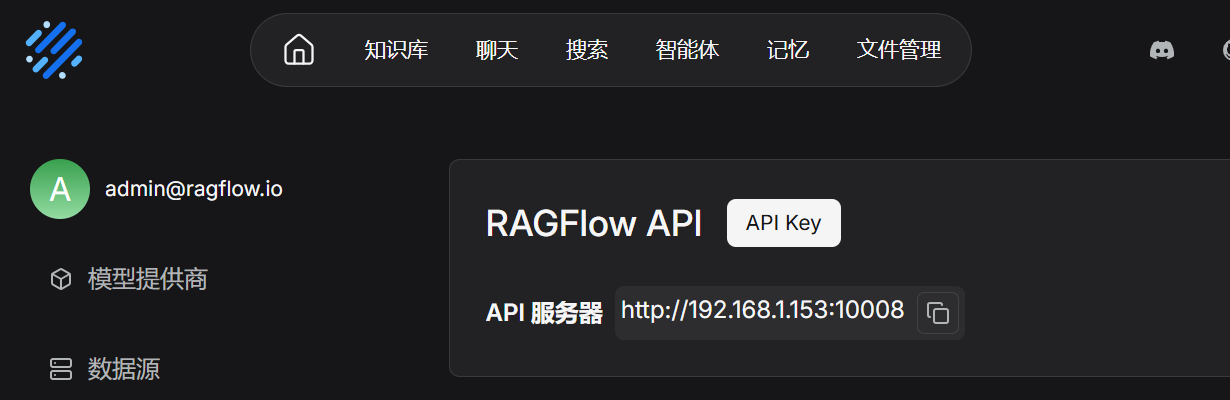
8. 获取知识库ID
打开 知识库 -> 选择某个知识库,然后URL中能看到知识库ID
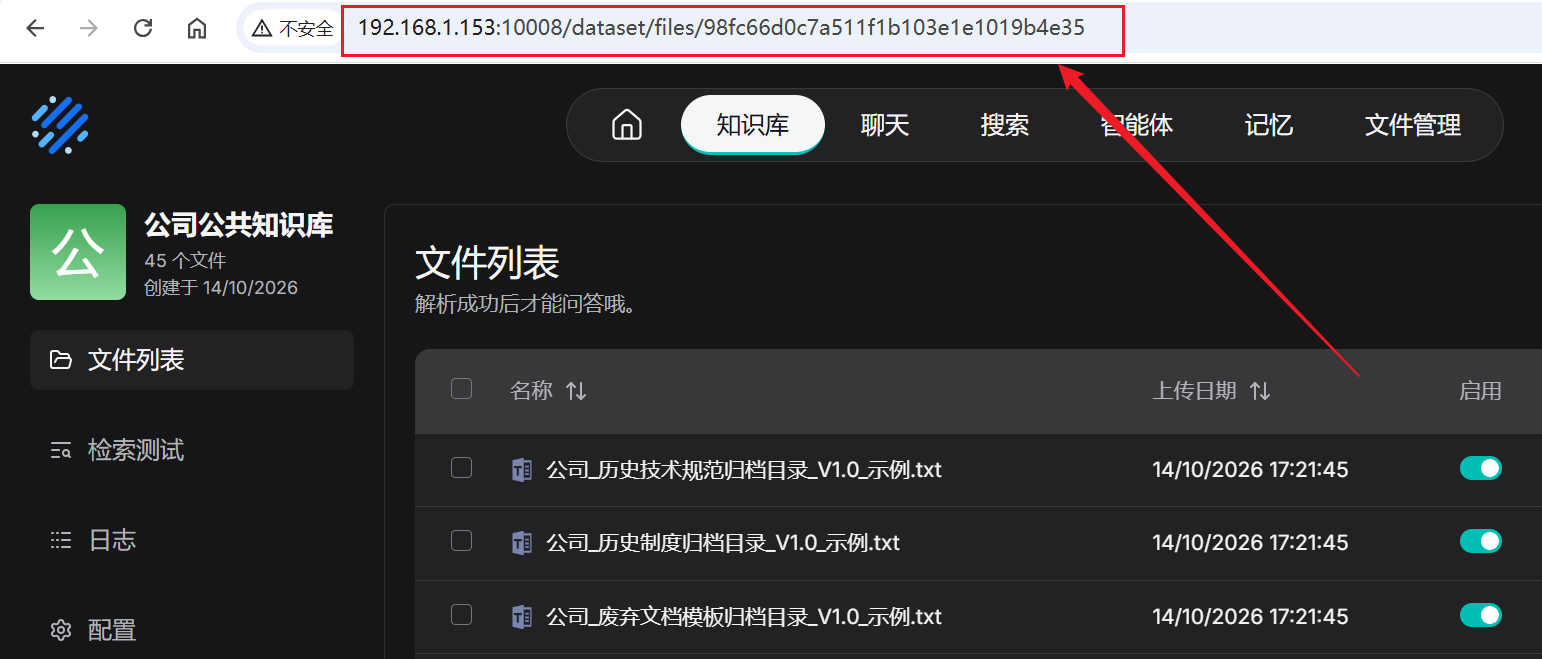
9. 安装 MCP
在浏览器访问 RAGFlow 的 MCP 服务,确认其可访问,其默认端口是 9382,例如: http://192.168.1.153:19382/mcp
在 Codex 中注册 RAGFlow MCP ,在 .codex\config.toml 文件中添加如下配置:(请替换真实的 API KEY)
[mcp_servers.ragflow]
url = "http://192.168.1.153:19382/mcp"
bearer_token_env_var = "RAGFLOW_API_KEY"
startup_timeout_sec = 60
tool_timeout_sec = 120